01
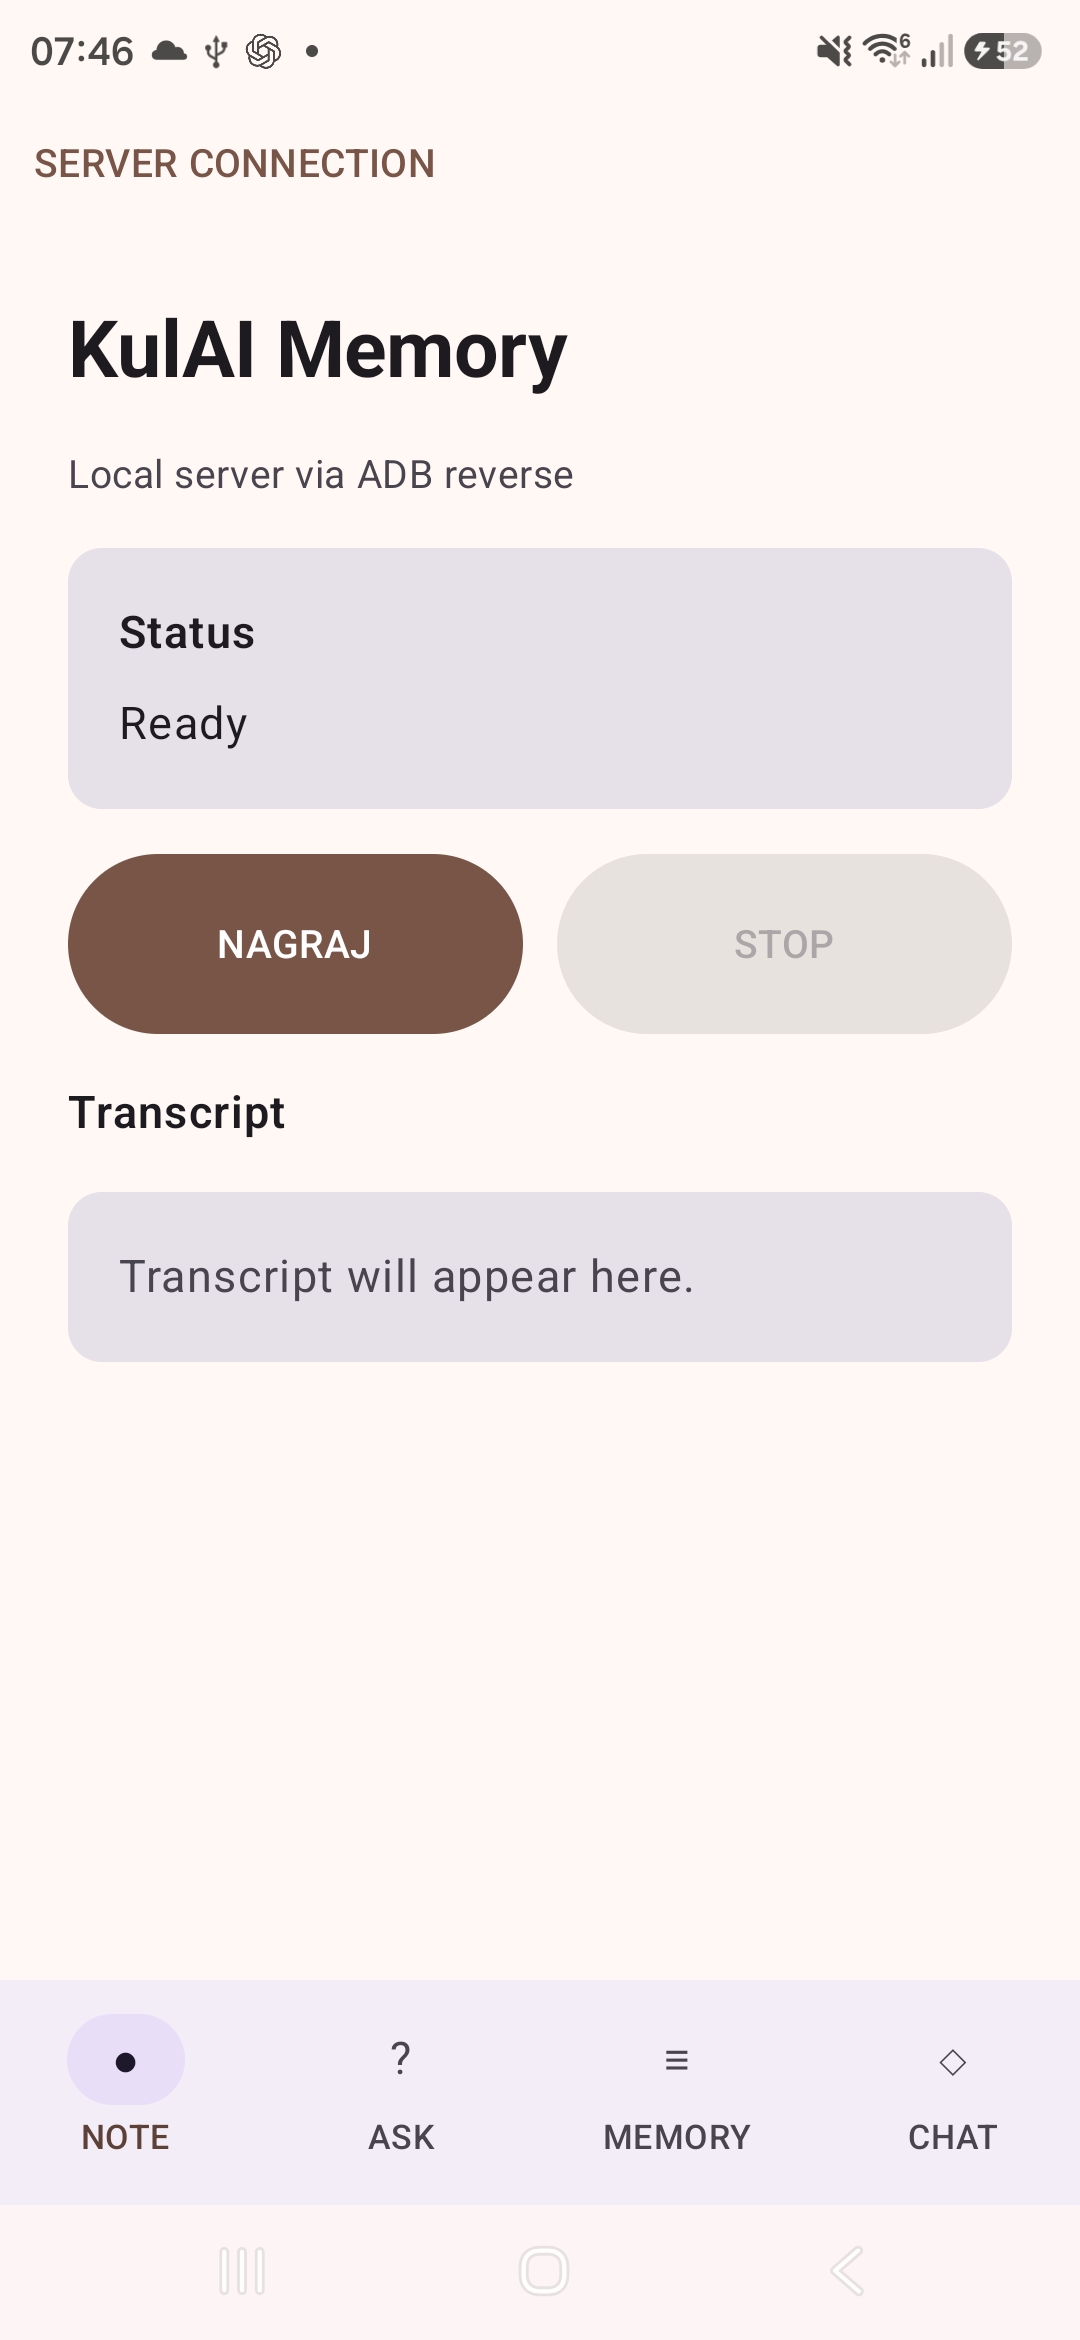
NOTE
Nagraj notatkę głosową, przepisz ją za pomocą Whisper i zapisz jej tekst jako trwały wpis w pamięci.
SYSTEM 09
Osobista pamięć AI oparta na lokalnych modelach i wyszukiwaniu semantycznym.
Interfejsy na Androida i komputer do nagrywania notatek głosowych, odnajdywania informacji z użyciem RAG i rozmów z lokalnym asystentem AI. Zaplecze działa na prywatnej infrastrukturze z PostgreSQL, Whisper, BGE-M3 i Qwen.
TOŻSAMOŚĆ SYSTEMU
STATUSDZIAŁAJĄCY PRYWATNY PROTOTYP
TYPLOKALNE AI / RAG / ANDROID + KOMPUTER
ŚRODOWISKOPrywatna infrastruktura
01 / PROBLEM I CEL
Pomysły, przydatne informacje i ustalenia często pojawiają się wtedy, gdy otwieranie notatnika i porządkowanie wpisu przerywa bieżące zajęcie. Później odnalezienie konkretnego szczegółu wymaga przeszukiwania rozproszonych notatek, choć nie pamiętamy już użytych słów.
KulAI Memory to prywatny projekt odpowiadający na ten codzienny problem: zapisz myśl głosem, zachowaj ją trwale i później zapytaj o potrzebną informację. Wyszukiwanie semantyczne pozwala odnaleźć treść na podstawie znaczenia, bez znajomości dokładnej frazy.
02 / ZRZUTY EKRANU APLIKACJI
Rzeczywiste ekrany prywatnego prototypu na Androida i komputer: nagrywanie notatek głosowych, zapisane informacje, odpowiedzi ze źródłami i rozmowy.
03 / GŁÓWNE FUNKCJE
01
Nagraj notatkę głosową, przepisz ją za pomocą Whisper i zapisz jej tekst jako trwały wpis w pamięci.
02
Przeglądaj zapisane informacje w bibliotece pamięci i wracaj do wcześniejszych notatek.
03
Zadaj pytanie tekstowo lub głosowo. RAG wyszukuje pasujące notatki i przekazuje Qwen kontekst do odpowiedzi z odniesieniami do źródeł.
04
Osobny tryb wieloturowej rozmowy w aplikacji Android, z utrwalaną historią. CHAT działa odrębnie od ASK i nie gwarantuje przeszukiwania całej pamięci przy każdej wypowiedzi.
05
Odsłuchuj odpowiedzi lokalnie po polsku i angielsku, korzystając z zainstalowanych głosów syntezy mowy.
04 / PRZEPŁYW RAG
Zapis notatki głosowej
Whisper zamienia mowę na tekst. PostgreSQL przechowuje właściwą notatkę, a osobny etap indeksowania tworzy jej embedding BGE-M3 i zapisuje wektor za pomocą pgvector.
Pytanie i wyszukiwanie semantyczne
W trybie ASK model BGE-M3 zamienia pytanie na wektor. Wyszukiwanie semantyczne wybiera pasujące notatki, a Qwen wykorzystuje ten kontekst do przygotowania odpowiedzi. Gdy brakuje przydatnego kontekstu, ASK informuje o niewystarczających danych, zamiast wymyślać wspomnienia.
BGE-M3 i Qwen to gotowe, wstępnie wytrenowane modele. Moim rozwiązaniem jest aplikacja, orkiestracja, trwały zapis danych oraz mechanizm RAG łączący modele z prywatnymi notatkami.
05 / ARCHITEKTURA SYSTEMU
Ścieżka żądania z Androida
Ścieżka wykonania na komputerze
Interfejs Android powstał w Kotlinie i Jetpack Compose oraz komunikuje się z FastAPI przez HTTP i WebSocket. Aplikacja komputerowa PySide6 wywołuje rdzeń aplikacji bezpośrednio we własnym procesie; w tej ścieżce nie uruchamia ani nie wywołuje FastAPI.
Rdzeń aplikacji odpowiada za zapis w PostgreSQL/pgvector i orkiestrację modeli. Whisper obsługuje transkrypcję, BGE-M3 tworzy embeddingi, a Qwen generuje odpowiedzi. Inferencja działa na prywatnym komputerze, a modele BGE-M3 i Qwen są udostępniane przez Ollama.
06 / BEZPIECZEŃSTWO I PRYWATNE AI
Notatki i embeddingi są przechowywane w prywatnej infrastrukturze PostgreSQL. Rozpoznawanie mowy, embeddingi i generowanie odpowiedzi korzystają z lokalnych modeli, więc ten proces nie wymaga wysyłania treści notatek do zewnętrznej usługi AI.
Warstwa bezpiecznego dostępu implementuje transport HTTPS/WSS z wzajemnym uwierzytelnianiem TLS na wejściu, autoryzację urządzeń i odnawialne sesje. Parowanie urządzenia wymaga lokalnej zgody administratora. Dostęp jest ograniczony do zatwierdzonych urządzeń w prywatnej instalacji.
07 / DECYZJE INŻYNIERSKIE
E-01
PostgreSQL zachowuje właściwe notatki, indeksy wektorowe i zapisy rozmów po restarcie aplikacji. Zmiany schematu odbywają się przez jawne migracje.
E-02
Zapis notatek i żądania rozmów mają stałe identyfikatory UUID. Ponowienie ukończonej operacji może wykorzystać zapisany wynik, zamiast tworzyć duplikat.
E-03
Zapis danych korzysta z transakcji i kontroli konfliktów. Wyszukiwanie zamyka migawkę bazy przed generowaniem odpowiedzi przez model, a tura rozmowy jest zapisywana jako pełna para pytanie–odpowiedź.
E-04
Embeddingi BGE-M3 i pgvector pozwalają trybowi ASK znajdować notatki według znaczenia. Odniesienia do źródeł łączą wygenerowaną odpowiedź z odnalezionym materiałem.
E-05
Whisper, BGE-M3 i Qwen mają osobne zadania: transkrypcję, tworzenie embeddingów i generowanie odpowiedzi. Łączy je orkiestracja na poziomie aplikacji.
E-06
Historia rozmów jest utrwalana z uporządkowanymi wiadomościami i ograniczonym kontekstem. Jawne typy błędów, obsługa anulowania i ponowienia ze stałymi identyfikatorami żądań pomagają odzyskać stan po przerwanych operacjach.
08 / TECHNOLOGIE I OBECNY STAN
KulAI Memory to działający prywatny prototyp, rozwijany i testowany na rzeczywistym urządzeniu Android.
Projekt pokazuje inżynierię aplikacji od początku do końca wokół lokalnego AI: interfejsy klienckie, granice backendu, trwałe dane, wyszukiwanie i kontrolowany dostęp.